- Méthode
- Automatisation
Pourquoi des tests verts manquent des défauts : la règle des trois passes

Réponse directe
Des tests verts ne garantissent pas que le collaborateur voit le bon total ni le bon périmètre. Ils confirment seulement les cas qu’ils exercent. Dans une réalisation pour le pôle social, j’ai vu deux défauts échapper aux suites vertes : une référence de coût déplacée, puis un cumul sur plusieurs exercices. Un autre test a rougi à raison. Depuis, je passe par les suites, la chaîne de preuve et l’écran.
Les faits de cet épisode sont consignés dans ma note de travail de juillet 2026 ; les sources Python citées en annexe éclairent seulement la méthode des tests, pas ces incidents.
Première passe : les suites, pour verrouiller les règles connues
Avant de montrer le résultat, j’écris une règle métier et son contre-exemple. Par exemple : si un dossier est suivi sur plusieurs exercices, le simulateur d’une année ne doit additionner que les lignes de cet exercice. Je teste ensuite les limites : exercice absent, dossier répété, montant nul par construction, changement de périmètre. Les tests que j’écris visent ces invariants au prochain changement ; ils ne démontrent pas que chaque sortie du classeur ou chaque ligne de l’interface est correcte.
Un test rouge n’est donc pas une gêne à faire disparaître. Dans cette réalisation, un contrôle destiné à vérifier que deux blocs n’empiétaient pas l’un sur l’autre a effectivement échoué après le passage des colonnes au-delà de Z. Le contrôle lui-même lisait une seule lettre pour calculer les bornes. La règle que j’en tire est de réparer cette lecture et de rejouer le scénario, pas de détendre l’assertion. Ce défaut n’a pas échappé à des tests verts : un test a rougi à raison.
Deuxième passe : la chaîne de preuve, pour relier l’entrée à la sortie
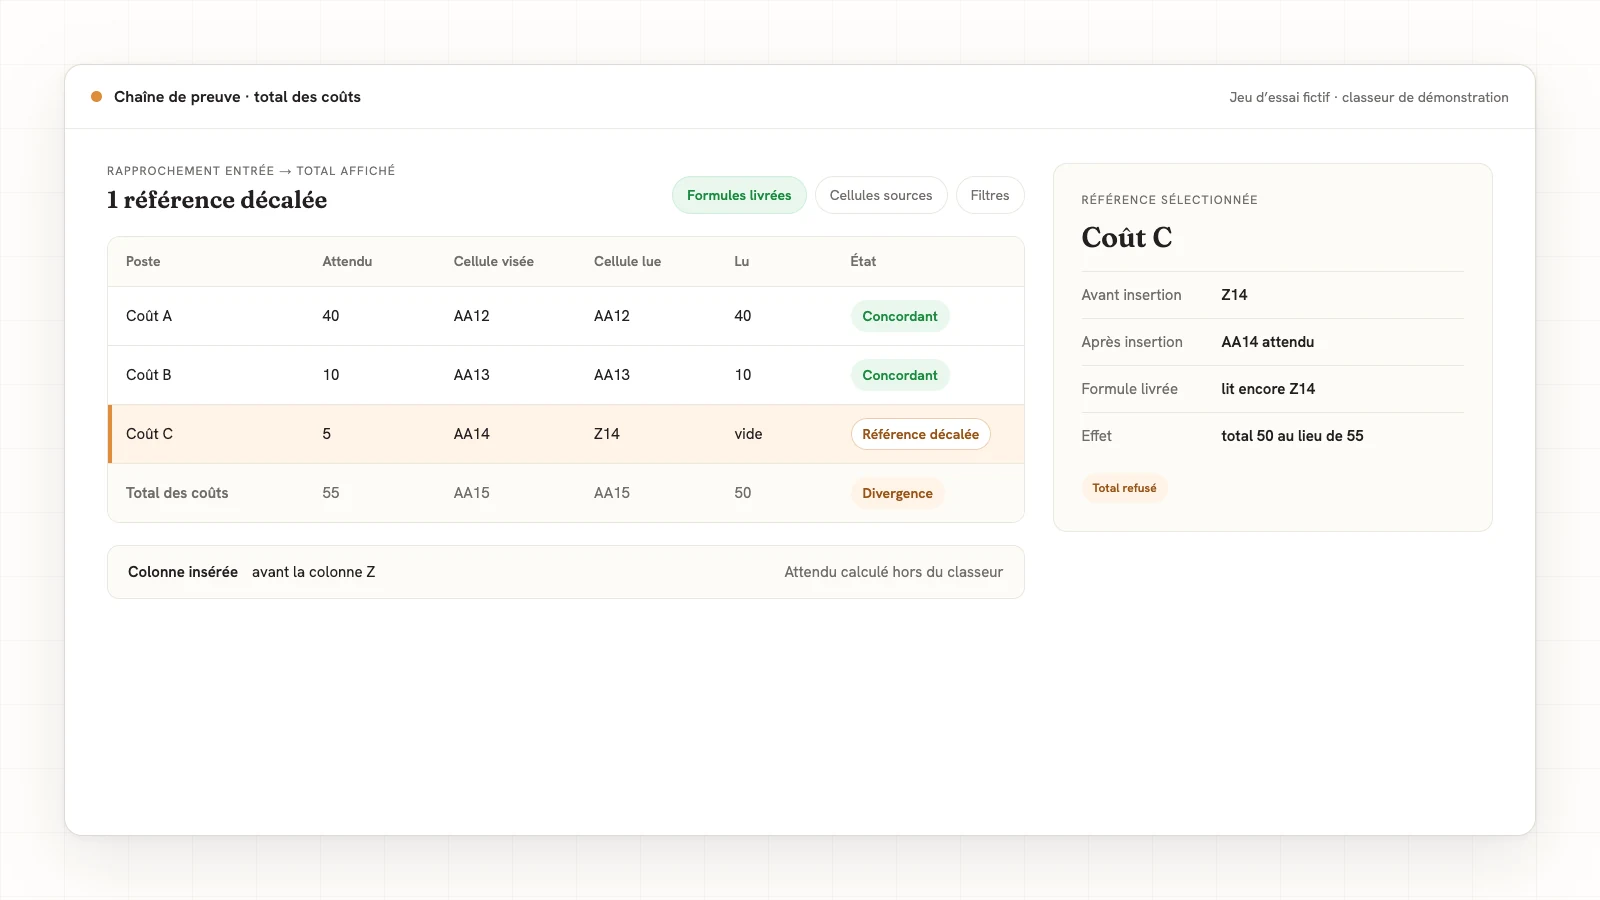
Je prends une entrée fictive, conserve le résultat attendu calculé séparément et compare chaque étape jusqu’au chiffre affiché. Dans cette réalisation, l’insertion d’une colonne avait déplacé trois références vers le total des coûts. Les suites étaient vertes ; la vérification de la chaîne de preuve a repéré 137 divergences. Le coût concret était de reprendre les références et de refaire les comparaisons ; je n’ai pas de durée mesurée à lui attribuer. Un calcul peut respecter les règles testées dans le code et afficher malgré tout un mauvais total une fois les formules déplacées.
La question utile n’est pas « le fichier s’ouvre-t-il ? », mais « peut-on remonter de ce total à chacune de ses entrées sans saut ni référence décalée ? ». Sur une sortie tabulaire, contrôlez les formules réellement livrées, les cellules sources et les filtres appliqués. Sur un export, rapprochez le total exporté et le total de l’outil de référence sur un jeu fictif stable.
Troisième passe : l’écran, pour refaire le geste humain
J’ouvre la vue réellement utilisée et me demande : quel dossier, quelle année, quel périmètre ce chiffre représente-t-il ? Dans ce même travail, le simulateur affichait pour un dossier un cumul de plusieurs années au lieu de l’année sélectionnée. Les suites n’avaient pas arrêté ce résultat ; la lecture de l’écran, avec un cas connu, a montré l’écart. Reprendre le périmètre du calcul et vérifier à nouveau la vue devenait nécessaire. Sans ce contrôle, un chiffre détaillé peut paraître crédible alors qu’il répond à une autre question.
La recette doit prévoir au moins un scénario où la décision change si le périmètre est mauvais : dossier présent sur deux exercices, exclusion d’une catégorie qui suit une autre grille, année incomplète. Notez à côté du résultat les exclusions et le périmètre retenu. Une capture ne suffit pas : quelqu’un doit expliquer pourquoi le chiffre affiché est celui qu’il utiliserait.
La règle écrite
La frontière. Je fais tester les règles connues et rapprocher les résultats par la chaîne de preuve ; la sortie attend encore une lecture à l’écran. Le cabinet décide si le périmètre affiché convient à son usage.
| Se prépare seul | Attend une validation | Reste humain |
|---|---|---|
| Contrôles automatisés et rapprochement sur données fictives | Confrontation du total au scénario métier | Acceptation du périmètre et décision d’utiliser le résultat |
La proposition. J’ai retenu une règle pour nos livraisons : proposer des contrôles et leurs résultats sans remplacer les saisies du cabinet. Une comparaison rouge nomme la divergence au lieu de corriger silencieusement un chiffre.
L’arrêt. J’interromps la recette devant une référence décalée, une année agrégée hors du périmètre ou un contrôle de colonnes erroné, jusqu’au correctif vérifié.
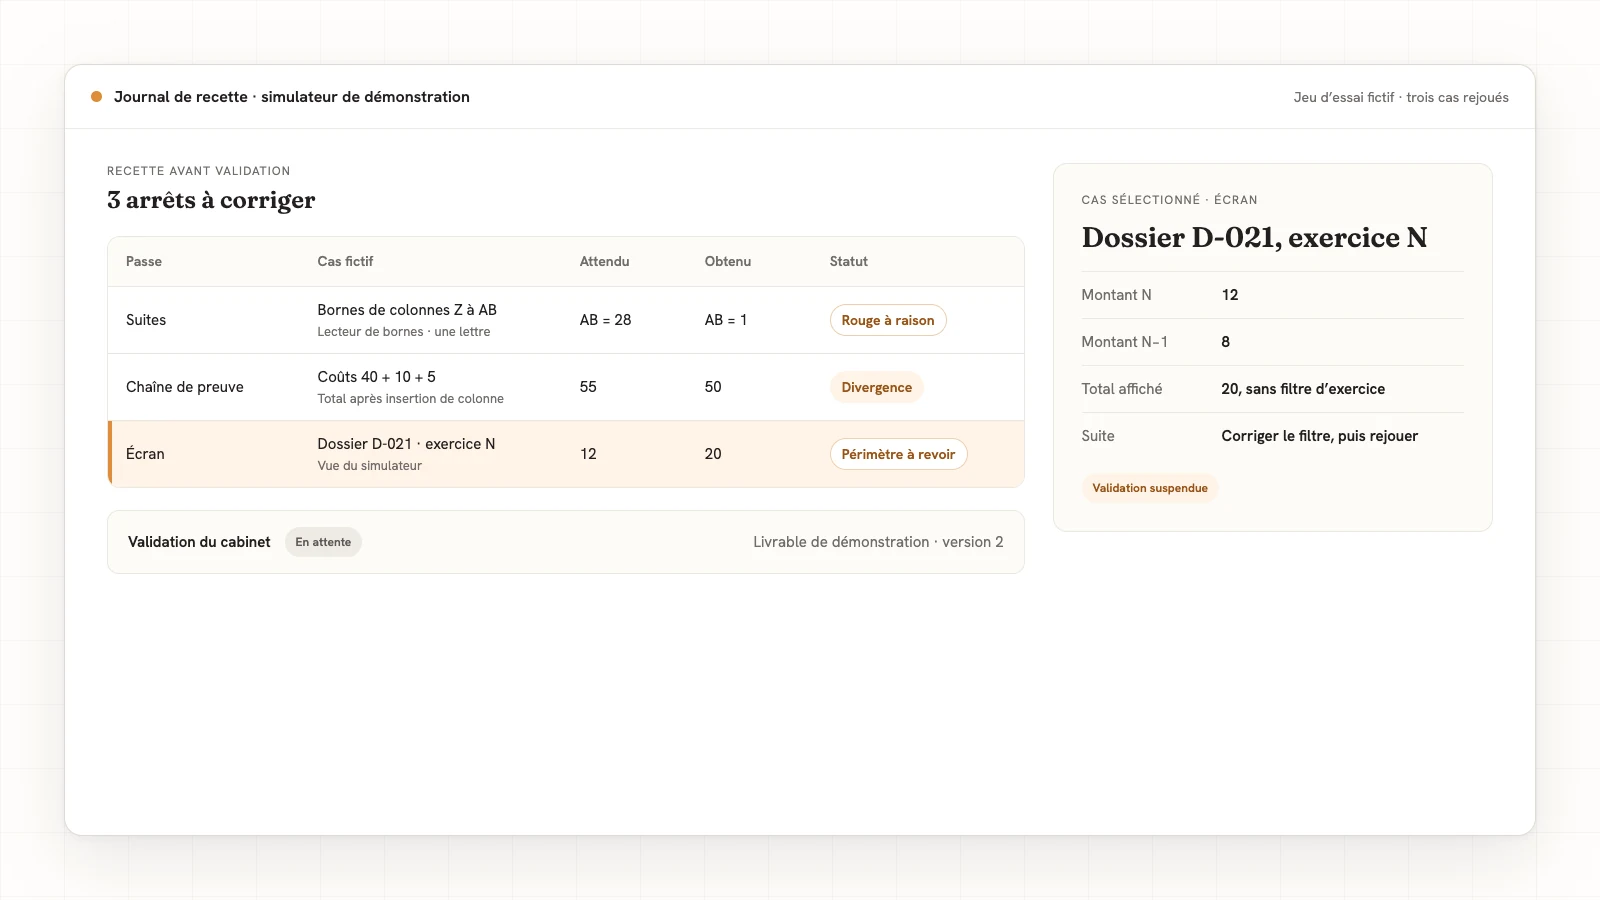
Le jeu d’essai. J’illustre cette règle avec trois situations fictives rejouées par une règle locale : un coût oublié, deux exercices agrégés et une borne AB tronquée. Les cadres les illustrent ; ni cet exercice ni les cadres ne rejouent le produit historique.
Rejoué sur le jeu fictif
| Cas joué | Sortie obtenue | Décision |
|---|---|---|
| Coûts fictifs 40 + 10 + 5, référence qui omet le dernier poste | Attendu 55, total avec référence décalée 50 : divergence |
Revoir les références avant d’accepter le total |
| Dossier fictif sur deux exercices, 12 en N et 8 en N−1 | Sans filtre 20, exercice N seul 12 | Corriger le filtre avant d’utiliser le résultat |
| Bornes fictives de Z à AB | Z = 26, AB = 28, ancien lecteur mono-lettre de AB = 1 | Lire la colonne entière et rejouer le contrôle |
Ces trois lignes sont des sorties d’une règle locale sur jeu fictif ; elles ne reproduisent ni les chiffres ni les captures de la réalisation historique.
Une fiche de recette que le cabinet peut reprendre
| Passe | À préparer | Question à poser avant validation |
|---|---|---|
| Suites | Règle, contre-exemple et jeu fictif | Les cas limites et l’échec attendu sont-ils testés ? |
| Chaîne de preuve | Entrées et résultat attendu indépendants | Les formules ou transformations du livrable mènent-elles au même total ? |
| Écran | Même scénario rejoué dans l’interface | Le libellé, l’année, les exclusions et le montant se comprennent-ils ensemble ? |
Ma règle depuis cet épisode : si l’une des trois passes échoue, je consigne le défaut, corrige sa cause et ajoute un test qui aurait détecté sa classe à l’avenir. Je relance les trois passes sur la sortie modifiée. Le bon critère n’est pas un compteur de tests ; c’est une règle que l’équipe peut vérifier et une décision qu’elle peut encore contester.
Cette recette s’applique aux tâches de la carte des automatisations du cabinet. Notre méthode inclut un jeu fictif et la validation par les personnes qui utiliseront le résultat. L’IA prépare ; l’humain décide. Si une tâche réclame encore trop de vérifications manuelles, confiez-nous cette tâche : nous regarderons d’abord ce qu’il faut rendre vérifiable dans vos outils existants.
Sources consultées
- Python Software Foundation, doctest — Exemples de tests interactifs en Python, consulté le .
- Python Software Foundation, unittest — Unit testing framework, consulté le .
- pytest, How to write and report assertions in tests, consulté le .